模型評估之混淆矩陣 從矩陣到洞察,全面解讀分類模型性能
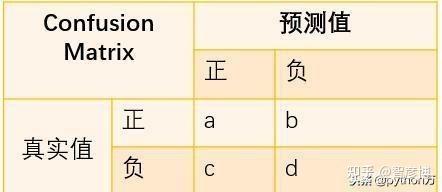
在機器學習領域,分類模型的評估至關重要。準確率雖然直觀,但在類別不平衡的場景下容易產生誤導。混淆矩陣(Confusion Matrix)作為一種基礎而強大的評估工具,能夠清晰展示模型在每個類別上的表現,是分類問題中不可或缺的分析手段。\n\n## 一、什么是混淆矩陣?\n\n混淆矩陣是一個 N×N 的表格(N 為類別數),用于分類模型的預測結果。以二分類為例,矩陣的每一行代表樣本的真實類別,每一列代表模型的預測類別(或相反,取決于約定)。典型布局如下:\n\n| | 預測為正類 | 預測為負類 |\n|----------------|------------|------------|\n| 真實正類 | TP | FN |\n| 真實負類 | FP | TN |\n\n其中:\n- TP(True Positive):正類被正確預測為正類\n- TN(True Negative):負類被正確預測為負類\n- FP(False Positive):負類被錯誤預測為正類(誤報)\n- FN(False Negative):正類被錯誤預測為負類(漏報)\n\n對于多分類問題,混淆矩陣擴展為K×K的表格,每個元素 (i, j) 表示真實類別為 i 但被預測為 j 的樣本數量。\n\n## 二、從混淆矩陣導出的核心指標\n\n混淆矩陣本身是一個計數矩陣,但通過它可以計算出多種評估指標,全面刻畫模型性能。\n\n### 1. 準確率(Accuracy)\n準確率 = (TP + TN) / (TP + TN + FP + FN)。\n
適用場景:類別分布均衡時。
局限:在類別不平衡時,高準確率可能意味著模型只是預測了多數類。\n\n### 2. 精確率(Precision)\n精確率 = TP / (TP + FP)。
表示預測為正的樣本中,實際為正的比例。
關注點:降低誤報(FP)。適用于垃圾郵件識別、推薦系統等場景。\n\n### 3. 召回率(Recall / Sensitivity)\n召回率 = TP / (TP + FN)。
表示真實為正的樣本中,被正確預測的比例。
關注點:降低漏報(FN)。適用于疾病診斷、欺詐檢測等場景。\n\n### 4. F1分數(F1-Score)\nF1 = 2 × (Precision × Recall) / (Precision + Recall)。
精確率和召回率的調和平均,綜合平衡兩者。\n\n### 5. 特異度(Specificity)\n特異度 = TN / (TN + FP)。
表示真實為負的樣本中,被正確預測的比例。\n\n### 6. 其他指標\n- 假正率(FPR):FP / (FP + TN) = 1 - 特異度\n- 假負率(FNR):FN / (FN + TP) = 1 - 召回率\n- 平衡準確率(Balanced Accuracy):(召回率 + 特異度) / 2\n- 馬修斯相關系數(MCC):綜合考慮TP, TN, FP, FN,取值范圍[-1, 1],適合不平衡數據。\n\n## 三、混淆矩陣的可視化\n\n熱力圖是最常見的可視化方式,用顏色深淺表示數值大小,能直觀看出模型在哪些類別上容易混淆。\n\n`python\nimport matplotlib.pyplot as plt\nimport seaborn as sns\nfrom sklearn.metrics import confusionmatrix\n\n# 假設 ytrue 為真實標簽,ypred 為預測標簽\ncm = confusionmatrix(ytrue, ypred)\nsns.heatmap(cm, annot=True, fmt='d', cmap='Blues')\nplt.xlabel('Predicted')\nplt.ylabel('Actual')\nplt.title('Confusion Matrix')\nplt.show()\n`\n\n通常還需對矩陣進行歸一化(按行或按列),以消除類別樣本量差異帶來的影響。\n\n## 四、多分類下的混淆矩陣分析\n\n多分類問題中,混淆矩陣能揭示哪些類別容易被混淆。例如,在手寫數字識別中,數字“3”可能常被誤判為“8”。分析矩陣的非對角線元素有助于發現模型弱點:\n\n- 類別級指標:可計算每個類別的精確率、召回率、F1分數,宏平均(Macro-average)、微平均(Micro-average)和加權平均(Weighted-average)。\n - 宏平均:各類別指標算術平均,平等對待每個類別。\n - 微平均:全局計算TP, FP, FN,然后計算指標,受樣本量大的類別主導。\n - 加權平均:按類別樣本量加權平均。\n\n## 五、混淆矩陣的應用案例\n\n### 1. 醫療診斷\n在癌癥篩查中,漏診(FN)代價極高,因此需要高召回率。通過混淆矩陣調整分類閾值,減少FN,即使增加FP。\n\n### 2. 欺詐檢測\n欺詐交易極少,屬于極度不平衡數據。僅看準確率可能高達99.9%,但模型可能從未預測出欺詐。混淆矩陣中的TP和FN才能真正反映檢測能力。\n\n### 3. 情感分析\n三分類(正面、負面、中性)中,混淆矩陣可幫助理解中性樣本是否與實際帶有情感傾向的樣本混淆。\n\n## 六、混淆矩陣的局限與注意事項\n\n- 閾值依賴:對于概率輸出模型,混淆矩陣依賴于分類閾值。默認0.5不一定最優,可通過ROC曲線或PR曲線選擇閾值。\n- 類別順序:二分類中“正類”的定義影響指標解讀;多分類中類別的排列順序影響可讀性。\n- 不平衡數據:需結合其他指標(如MCC、Kappa系數、F1)綜合判斷。\n- Kappa系數:衡量分類一致性,排除隨機一致性的影響。\n\n## 七、\n\n混淆矩陣是分類模型評估的基石,它像一面鏡子,清晰地映射出模型在每個類別上的表現。從矩陣出發,我們可以計算出精確率、召回率、F1分數等一系列指標,并通過可視化深入理解模型的優勢與不足。在實際應用中,應結合具體業務場景選擇合適指標,并注意類別不平衡、閾值選擇等問題,從而構建更可靠、更有價值的分類模型。
如若轉載,請注明出處:http://www.gxnjr.com.cn/product/51.html
更新時間:2026-11-05 08:30:12